Tobii 4C: il beccheggio della testa ritrovato nel viso, per ora con una webcam
Con due soli occhi il "sì" della testa non si vede. Racconto come ho ricavato il beccheggio dai 478 punti del viso di MediaPipe Face Landmarker con un prototipo su una webcam USB, in attesa di portarlo sulle immagini infrarosse del Tobii 4C, e che cosa non so ancora.
Nella voce precedente avevo lasciato un problema aperto. Il Tobii Eye Tracker 4C non manda la posa della testa. Dai due centri corneali, cioè dalla posizione nello spazio dei due occhi, si ricavano la posizione della testa, l’imbardata (yaw, il “no”) e il rollio (roll, la testa inclinata verso una spalla). Il beccheggio (pitch, il “sì”) invece non è osservabile: la rotazione avviene attorno a un asse che passa quasi per i due occhi, e i due punti restano praticamente fermi.
In questa voce racconto come ho affrontato il problema con un prototipo, scritto con l’aiuto dell’assistente AI di cui parlavo: un programma di prova che ricava il beccheggio dal viso invece che dai soli occhi. Per ora lavora sulle immagini di una webcam USB, non su quelle del 4C. Portarlo sulle immagini infrarosse (IR) del sensore è il passo successivo.
Non ci sono misure di accuratezza: c’è un metodo, una schermata e un elenco onesto di dubbi.
L’idea: un viso ha molti più punti di due occhi
Se due punti non bastano, servono altri punti che non stiano sull’asse del “sì”. La punta del naso, il mento e la fronte vanno benissimo. Quando si annuisce, la punta del naso, che sporge in avanti, si sposta in su o in giù rispetto agli occhi. È proprio l’informazione che mancava.
Per trovare questi punti nelle immagini uso MediaPipe Face Landmarker, un insieme di modelli di
Google per l’analisi del volto. Il pacchetto ufficiale ne contiene tre: un rilevatore di volti
(BlazeFace), un modello dei punti del viso e un modello delle espressioni
(Google AI Edge, s.d.). Il prototipo ne usa uno solo, la rete
face_landmarks_detector.
Questa rete riceve un ritaglio quadrato del viso di 256 × 256 pixel e restituisce:
- 478 punti 3D: 468 formano una maglia (mesh) che copre il volto, 10 descrivono le iridi, 5 per occhio, cioè il centro e quattro punti del bordo (Yan e Grishchenko, 2022; Ablavatski et al., 2020, preprint);
- una probabilità che nel ritaglio ci sia davvero un viso.
Ogni punto ha due coordinate in pixel e una terza, z, che è una profondità relativa: dice se un punto sta più avanti o più indietro rispetto al centro del viso, non a quanti millimetri dalla camera (Yan e Grishchenko, 2022). Il modello deriva da un lavoro di Google sulla stima della geometria del volto con una sola telecamera (Kartynnik et al., 2019, preprint).
La rete è distribuita con licenza Apache 2.0 (Yan e Grishchenko, 2022). Nel prototipo uso una conversione nel formato ONNX fatta da terzi, che dichiara di non aver modificato i pesi (senty-au, s.d.). Il file pesa 4,9 MB, è incorporato nel programma, e il programma ne controlla l’impronta SHA-256.
Un interprete scritto da zero
Per eseguire una rete neurale di solito si usa una libreria come TensorFlow o ONNX Runtime. Nel prototipo ho fatto un’altra scelta: un piccolo interprete in Go che legge il file del modello e sa eseguire solo le operazioni che servono a questa rete (convoluzioni, somme, funzioni di attivazione, cambi di forma dei dati).
È coerente con gli obiettivi che mi ero dato nella voce precedente: nessun componente proprietario, poche dipendenze, memoria preparata all’avvio e riutilizzata. L’interprete usa le istruzioni vettoriali AVX2 e FMA dei processori recenti, se ci sono; altrimenti ripiega sul codice Go normale.
Un’inferenza costa 113 milioni di moltiplicazioni-accumulo (MAC), cioè operazioni del tipo “moltiplica due numeri e somma il risultato a un totale”.
Trovare il viso e ritagliarlo
La rete non cerca il viso in tutta l’immagine. Si aspetta un ritaglio con il viso al centro, un margine attorno e la linea degli occhi orizzontale; tollera solo piccoli errori di posizione e di rotazione (Yan e Grishchenko, 2022). Il lavoro vero, quindi, è preparare il ritaglio giusto. Il prototipo ha due strade:
- Inseguimento. Se poco prima (entro 1,5 secondi) c’era un viso, il nuovo ritaglio si ricava dai suoi punti: centrato sul viso, 1,5 volte più grande e ruotato in modo che la linea tra gli angoli esterni degli occhi sia orizzontale. Basta un’inferenza.
- Ricerca a griglia. Altrimenti il programma prova ritagli di tre grandezze (60 %, 40 % e 85 % del lato corto dell’immagine) su una griglia con passo di mezzo lato, dal centro verso i bordi. Si ferma al primo ritaglio con probabilità sopra 0,95, poi affina il risultato con l’inseguimento. Costa fino a una trentina di inferenze.
Il rilevatore BlazeFace del pacchetto non viene usato: per trovare il viso basta la probabilità restituita dalla stessa rete dei punti. Per non sprecare calcolo, se la ricerca a griglia non trova nulla viene ripetuta sempre più di rado, fino a una volta ogni 2 secondi.
Prima di passare il ritaglio alla rete, il programma normalizza il contrasto: stira i grigi tra il 1° e il 99° percentile del ritaglio. È una scelta pensata per le immagini IR, che sono scure e cambiano con l’esposizione automatica, mentre il modello è stato addestrato su foto a colori ben esposte. L’immagine è in bianco e nero, quindi lo stesso grigio viene copiato nei tre canali di colore che la rete si aspetta.
Dai punti agli angoli: appoggiare una maschera sul viso
Una volta trovati i punti, bisogna capire come è orientata la testa. Qui il prototipo segue la
stessa strada del modulo face_geometry di MediaPipe (The MediaPipe Authors, 2020).
L’idea si capisce con un’immagine. Immaginate una maschera rigida, un viso medio in 3D, e di doverla appoggiare sul viso visto dalla camera, ruotandola, spostandola e scalandola finché i suoi punti coincidono il più possibile con quelli trovati dalla rete. La rotazione che serve per farla combaciare è la rotazione della testa.
La maschera è il modello canonico del viso di MediaPipe. Il prototipo ne usa 33 punti, quelli più rigidi: punti del naso, degli zigomi, degli angoli degli occhi e della fronte. Ognuno ha un peso, preso anch’esso da MediaPipe (Apache 2.0).
Il metodo per trovare la rotazione che sovrappone meglio due insiemi di punti si chiama analisi di Procrustes. Il prototipo usa la soluzione in forma chiusa di Horn, basata sui quaternioni (Horn, 1987). Il calcolo procede in tre passi:
- Scala. Un primo confronto tra la maschera, in millimetri, e i punti, in pixel, dice quanti pixel vale un millimetro del viso. Da qui, con la focale della camera, si stima la distanza. Un esempio: se un millimetro del viso occupa 0,8 pixel e la focale è di 554 pixel, il viso è a circa 554 / 0,8 ≈ 690 mm.
- Punti in 3D. Ogni punto viene riportato nello spazio lungo il raggio della camera che lo attraversa, a quella distanza più la sua profondità relativa.
- Rotazione. Un secondo Procrustes, ora tra punti 3D in millimetri, dà la rotazione. Se la scala trovata non è 1, la distanza usata era sbagliata: il programma la corregge e ripete i passi 2 e 3, per tre volte.
Si noti che questo non è il classico metodo PnP (Perspective-n-Point), che cerca la posa confrontando i punti 3D di un modello con i loro pixel nell’immagine. Qui si allineano punti 3D con punti 3D, come in MediaPipe.
La rotazione finale viene scomposta in tre angoli, nell’ordine imbardata, beccheggio, rollio. Il beccheggio è l’elevazione della direzione in cui guarda il viso: positivo verso l’alto. I nomi degli angoli sono quelli della voce precedente (Murphy-Chutorian e Trivedi, 2009).
Il banco di prova: la webcam
Il prototipo si chiama “Viso dalla webcam”. Legge le immagini direttamente dal sistema video di Linux (V4L2), senza librerie in C, e mostra a schermo intero l’immagine con i punti del viso e tutte le misure del momento.
Per le prove ho usato una webcam USB ad alta risoluzione, letta qui a 640 × 480: la schermata qui sotto non viene dal Tobii 4C.
L’immagine è in bianco e nero: il programma prende solo la luminanza, come arriva dalla webcam, e lavora su immagini a un solo canale. È una scelta voluta, per avvicinarsi alle immagini IR del sensore, che sono anch’esse in scala di grigi.
C’è una differenza importante. La webcam non è calibrata: gli angoli sono calcolati rispetto all’asse della webcam, con una focale ipotizzata a partire dal campo visivo orizzontale, 60° per impostazione predefinita. Per un’immagine larga 640 pixel la focale vale 320 / tan(30°) ≈ 554 pixel. Senza calibrazione la focale è un’ipotesi: gli angoli ne dipendono poco, le distanze in proporzione.
Il programma calcola anche alcune misure in più:
- distanza dall’iride. Il diametro orizzontale dell’iride è quasi lo stesso in una popolazione ampia, 11,7 ± 0,5 mm (Vakunov e Lagun, 2020). Conoscendo il suo diametro in pixel e la focale, si ricava la distanza. Il programma usa l’iride meno di scorcio;
- EAR (eye aspect ratio), il rapporto tra l’altezza e la larghezza dell’occhio calcolato su sei punti delle palpebre e degli angoli (Soukupová e Čech, 2016). È quasi costante a occhio aperto e scende verso zero quando l’occhio si chiude;
- ammiccamenti. Il programma considera l’occhio chiuso quando l’EAR medio dei due occhi scende sotto il 70 % del valore tipico degli ultimi 5 secondi, e riaperto sopra l’80 %. Una chiusura conta come ammiccamento se dura al massimo 700 ms. Soukupová e Čech usano invece un classificatore su una finestra di fotogrammi: la soglia adattiva del programma è una scelta più semplice;
- MAR (mouth aspect ratio), definito nel programma come l’apertura interna delle labbra divisa per la larghezza interna della bocca.
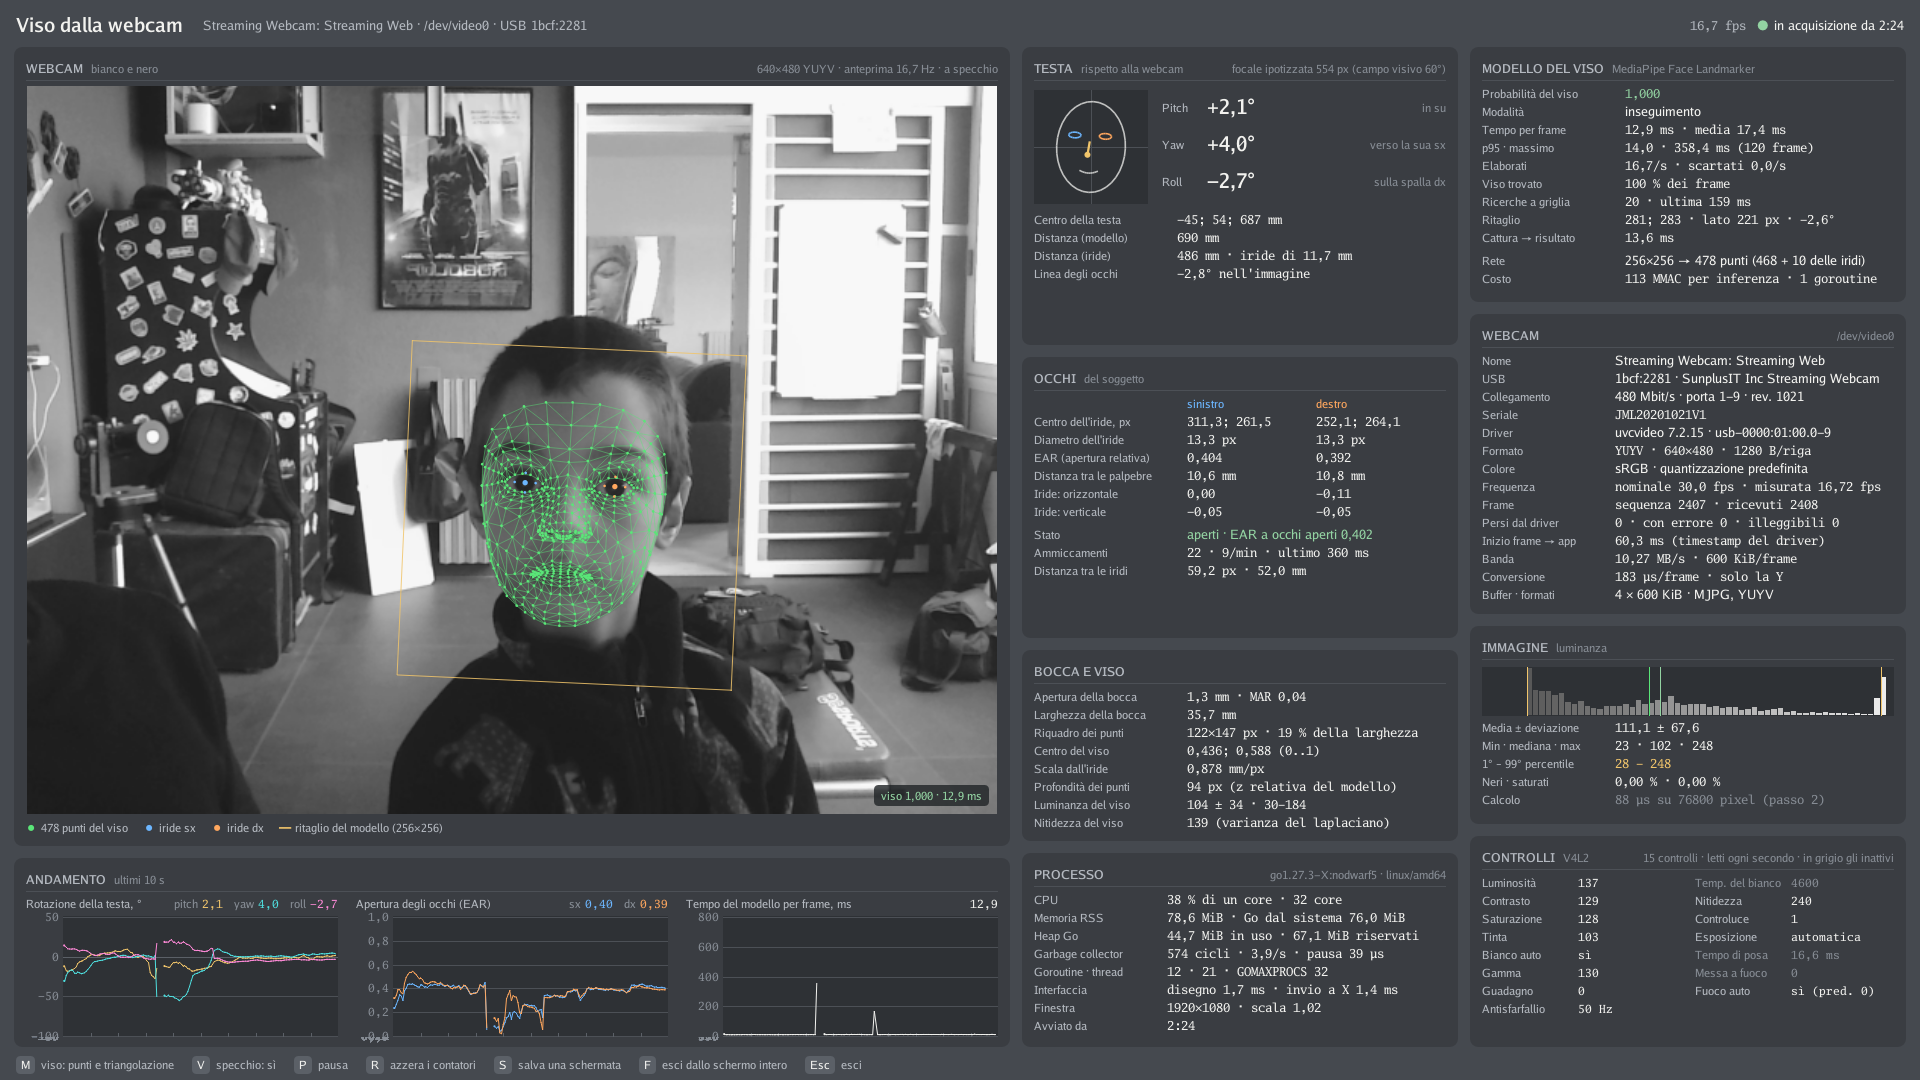
Come leggere la schermata
La schermata mostra un istante, con una persona. I numeri servono a capire che cosa mostra l’interfaccia, non a misurare l’accuratezza.
| Pannello | Valori in questo istante |
|---|---|
| Webcam | 640 × 480 YUYV, 16,7 fotogrammi al secondo misurati (30 nominali) |
| Testa | pitch +2,1°, yaw +4,0°, roll −2,7°; focale ipotizzata 554 px (campo visivo 60°) |
| Distanze | 690 mm dal modello canonico, 486 mm dall’iride (iride di 11,7 mm) |
| Occhi | EAR 0,404 (sinistro) e 0,392 (destro); 22 ammiccamenti, 9 al minuto |
| Modello del viso | 12,9 ms per fotogramma, media 17,4 ms, p95 14,0 ms, massimo 358,4 ms; 256 × 256 → 478 punti; 113 MMAC per inferenza |
| Processo | 38 % di un core |
Due dettagli meritano una spiegazione.
La media è più alta del 95° percentile. Sembra strano, ma non lo è. Il tempo per fotogramma è calcolato sugli ultimi 120 fotogrammi, e tra questi ci sono anche le ricerche a griglia, molto più lente di un’inferenza normale (il massimo è 358,4 ms). Pochi valori molto alti spostano la media ma non il percentile.
La webcam va a 16,7 fotogrammi al secondo invece di 30. Ho visto che in una stanza poco illuminata questa webcam scende da sola a circa 17 fotogrammi al secondo, per l’esposizione automatica.
La stessa interfaccia in movimento
Una schermata ferma non fa vedere la cosa più importante: il beccheggio che cambia mentre la testa si muove. Nel video, circa 19 secondi della stessa interfaccia, una persona annuisce, gira la testa a destra e a sinistra, apre la bocca e chiude gli occhi. Nel pannello Testa e nel grafico della rotazione in basso a sinistra si vede il beccheggio salire e scendere con il “sì”, separato dall’imbardata del “no”. Anche qui i numeri sono quelli del momento, non misure di accuratezza.
Due distanze che non tornano
La differenza più vistosa è tra le due distanze: 690 mm dal modello canonico e 486 mm dall’iride. Il modo in cui sono calcolate spiega una parte della differenza, non tutta.
- Non misurano lo stesso punto. La distanza “del modello” è quella dell’origine del modello canonico, che sta dietro la radice del naso. Nel modello canonico gli angoli degli occhi sono circa 3–4 cm più avanti di quell’origine. Qualche centimetro di differenza è quindi atteso.
- Usano due righelli diversi. La distanza dal modello presuppone che il viso abbia le dimensioni del viso medio di MediaPipe: se il viso è più grande o più piccolo, cambia solo la distanza stimata, non gli angoli. La distanza dall’iride presuppone un’iride di 11,7 mm.
- La focale da sola non basta a spiegarla. Per come sono scritte le formule, entrambe le distanze crescono in proporzione alla focale ipotizzata, quindi un errore sulla focale cambierebbe tutte e due nello stesso rapporto.
Restano circa 16–17 cm che non so spiegare. Non so neanche quale delle due sia più vicina al vero: in quel momento non ho misurato la distanza reale. È una questione aperta.
Il passo successivo: portarlo sul 4C
Nella voce precedente avevo scritto che il passo successivo sarebbe stato scrivere un driver libero per GNU/Linux. Il prototipo con la webcam serve a preparare quel lavoro: quando il 4C mi darà le sue immagini infrarosse, il metodo dovrà funzionare anche lì. Alcune cose, però, sulla webcam non ci sono e andranno aggiunte.
- La camera del 4C andrà calibrata. Sulla webcam la focale è un’ipotesi. Per avere angoli e distanze affidabili sul sensore servirà conoscere davvero la sua camera.
- Gli angoli andranno riportati allo schermo. Sulla webcam sono riferiti all’asse della camera. Per Kite conta come è girata la testa rispetto allo schermo.
- Il beccheggio andrà filtrato. Prevedo di usare un filtro 1 € (one euro filter), che smussa le piccole oscillazioni della misura (Casiez et al., 2012). Il nome è un gioco di parole degli autori: il filtro è così semplice ed economico da calcolare da “costare” un euro; con il denaro non c’entra nulla. Il filtro adatta l’intensità alla velocità della testa: quando la testa è ferma smussa molto e toglie il tremolio, quando la testa si muove in fretta smussa poco, così il valore non resta indietro rispetto al movimento. Il prototipo con la webcam, per ora, mostra i valori senza filtro.
Il problema aperto: un modello per foto a colori su immagini infrarosse
Nella voce precedente avevo scritto che non sapevo se un modello addestrato su immagini a colori avrebbe funzionato sulle immagini IR del 4C. Il dubbio resta. La scheda del modello lo rafforza: la rete è ottimizzata per video ripresi con la camera frontale degli smartphone, e i dati di addestramento sono stati raccolti con camere di smartphone (Yan e Grishchenko, 2022). Le immagini del 4C sono infrarosse, scure, riprese da vicino e dal basso.
Ecco che cosa posso dire, con onestà:
- Che cosa ho fatto: il prototipo lavora in scala di grigi, normalizza il contrasto di ogni ritaglio e copia il grigio nei tre canali. Non ho riaddestrato la rete.
- Che cosa ho osservato: sulla webcam, in bianco e nero, la rete trova il viso. Nella schermata il pannello del modello indica il viso trovato nel 100 % dei fotogrammi e la modalità di inseguimento, cioè il viso seguito da un fotogramma all’altro senza nuove ricerche.
- Che cosa non so: se la rete funzionerà sulle immagini IR del 4C, e con quale precisione; come si comporti con altre persone, con gli occhiali, con altre carnagioni, a distanze diverse o con un’altra illuminazione della stanza. Su questo non ho misure.
Problemi aperti
- Accuratezza del beccheggio. Non l’ho ancora misurata. Serve un confronto con un riferimento indipendente.
- Una sola persona. Le prove fatte finora sono con un solo viso.
- Le due distanze della webcam, 690 mm contro 486 mm, ancora senza una spiegazione completa.
- Il costo. Nell’istante della schermata il programma usa il 38 % di un core. Bisognerà capire quanto costerà sul computer che userà Kite, e quante inferenze al secondo servono davvero.
- L’apertura degli occhi. Nella voce precedente mi chiedevo se il 4C la fornisca in modo diretto. L’EAR calcolato dai punti del viso potrebbe essere un’alternativa, ma per ora l’ho visto solo sulla webcam.
Prossimi passi
- Misurare il beccheggio contro un riferimento, per esempio a inclinazioni note della testa.
- Misurare la distanza reale davanti alla webcam, per capire quale delle due stime sbaglia e perché.
- Provare il prototipo con altre persone, con il loro consenso informato.
- Portare il metodo sulle immagini IR del 4C, insieme al driver libero, e verificare se la rete funziona su quelle immagini.
- Valutare se l’EAR sia abbastanza affidabile per un ammiccamento volontario usato come clic in Kite.
Avvertenza. Kite è un progetto sperimentale e non è un dispositivo medico certificato. La stima della posa della testa descritta qui non ha ancora un’accuratezza misurata, e la scheda del modello di Google precisa che la rete non è pensata per decisioni critiche per la vita delle persone. Quando lavorerò sul 4C con un driver non ufficiale, userò il tracciatore in modi non previsti dal produttore: inviare comandi di cui non si conosce l’effetto potrebbe cambiarne il comportamento, compresi gli illuminatori infrarossi. Chi dipende da uno strumento di CAA per comunicare dovrebbe avere sempre un’alternativa di riserva. Le prove con persone richiedono il consenso informato e, quando serve, il parere di un comitato etico; le immagini del viso sono dati personali.
Riferimenti
- Ablavatski A., Vakunov A., Grishchenko I., Raveendran K., Zhdanovich M. (2020). Real-time pupil tracking from monocular video for digital puppetry. arXiv (preprint). arXiv:2006.11341
- Casiez G., Roussel N., Vogel D. (2012). 1 € filter: a simple speed-based low-pass filter for noisy input in interactive systems. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI ‘12), 2527–2530. doi:10.1145/2207676.2208639
- Google AI Edge (s.d.). MediaPipe Face Landmarker. Documentazione tecnica ufficiale. developers.google.com
- Horn B. K. P. (1987). Closed-form solution of absolute orientation using unit quaternions. Journal of the Optical Society of America A, 4(4), 629–642. doi:10.1364/JOSAA.4.000629
- Kartynnik Y., Ablavatski A., Grishchenko I., Grundmann M. (2019). Real-time facial surface geometry from monocular video on mobile GPUs. arXiv (preprint). arXiv:1907.06724
- Murphy-Chutorian E., Trivedi M. M. (2009). Head pose estimation in computer vision: a survey. IEEE Transactions on Pattern Analysis and Machine Intelligence, 31(4), 607–626. doi:10.1109/TPAMI.2008.106
- senty-au (s.d.). face_landmarks_detector-ONNX [conversione in ONNX della rete
face_landmarks_detectordi MediaPipe, non ufficiale]. Hugging Face. huggingface.co/senty-au/face_landmarks_detector-ONNX - Soukupová T., Čech J. (2016). Real-time eye blink detection using facial landmarks. 21st Computer Vision Winter Workshop (CVWW 2016), Rimske Toplice, Slovenia. PDF
- The MediaPipe Authors (2020). Modulo face_geometry: modello canonico del viso e base di
Procrustes (
geometry_pipeline_metadata_landmarks.pbtxt), licenza Apache 2.0. GitHub, google-ai-edge/mediapipe. github.com/google-ai-edge/mediapipe - Vakunov A., Lagun D. (2020, 6 agosto). MediaPipe Iris: real-time iris tracking & depth estimation. Google Research Blog. research.google
- Yan G., Grishchenko I. (2022). Model card: MediaPipe FaceMesh (15 settembre 2022). Google, licenza Apache 2.0. PDF